人工智能+虚拟细胞的构建
VIRTUAL CELL CONSTRUCTION · AI + VIRTUAL SIMULATION
本实验依据公开的生物医药企业肿瘤药物研发流程设计:靶点验证、耐药解析与组合用药评估依赖大规模基因敲除和药物处理实验,成本高、周期长,企业较多采用计算模型先行筛选、湿实验重点验证的干湿结合模式,对兼具建模与结果解读能力的复合型技术人才需求迫切。
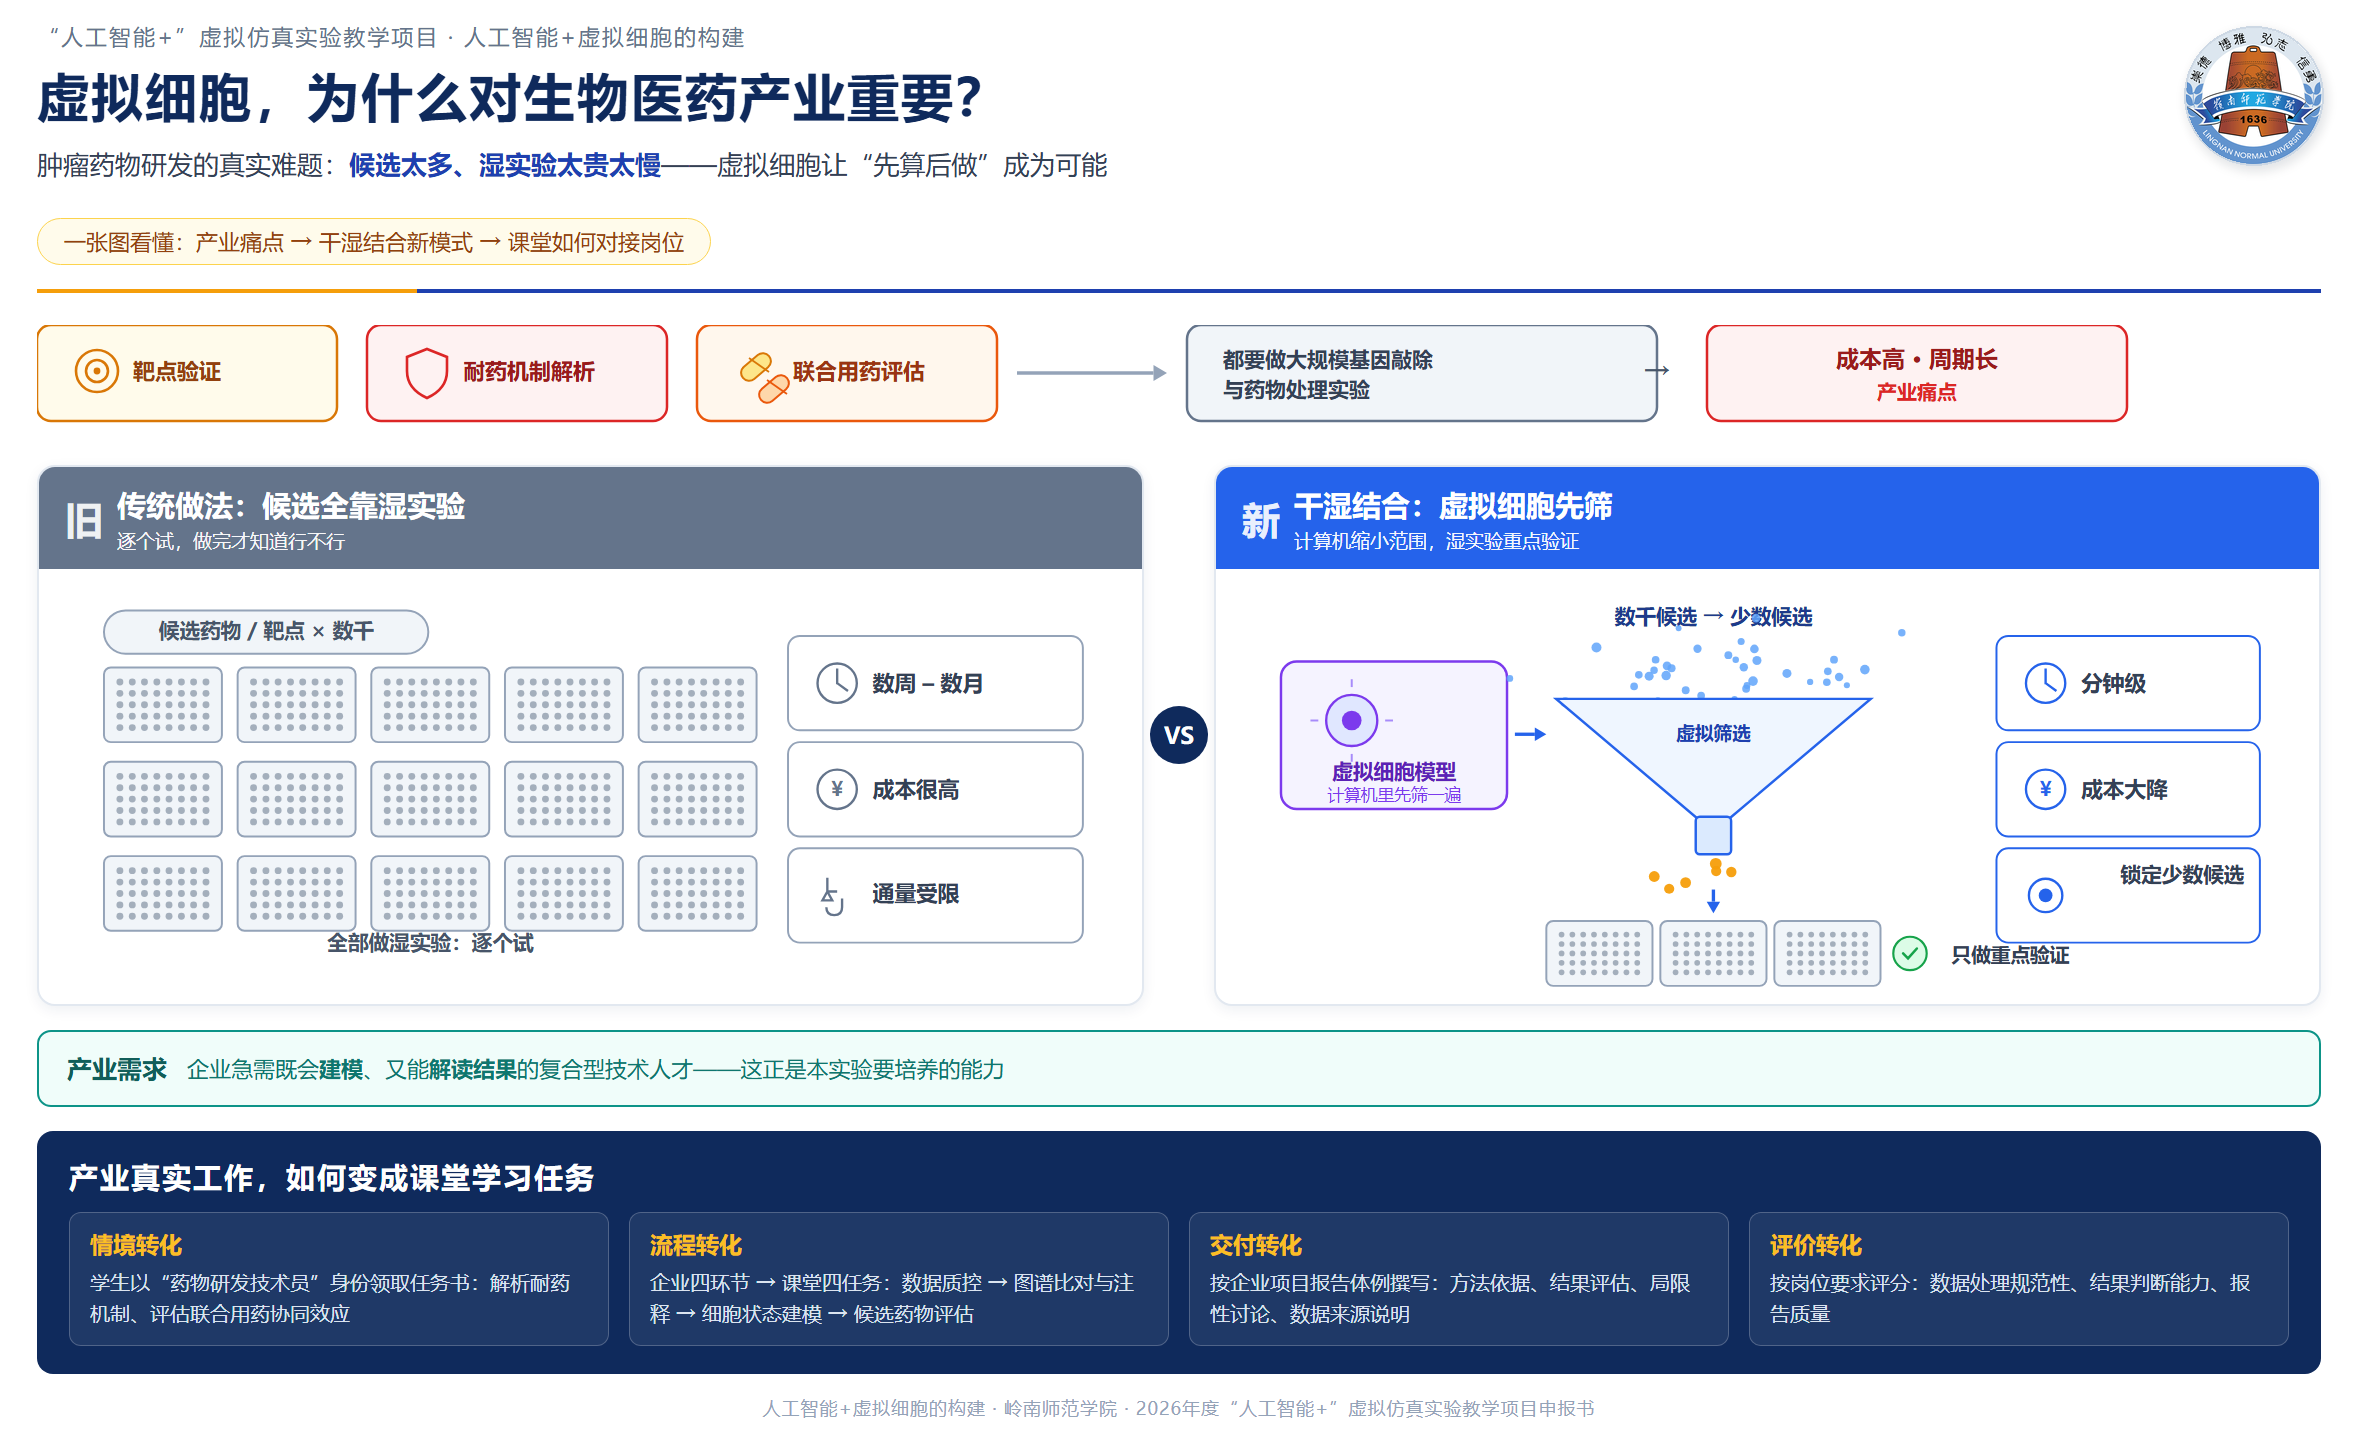
学生以药物研发技术员身份接收任务书,如“解析某肿瘤细胞系对候选药物的耐药机制”“比较候选药物联合用药的表达响应差异”,明确研究目标、数据资源与交付要求。
产业流程的数据获取与质控、图谱比对与细胞类型注释、细胞状态建模、候选药物评估四个环节分别转化为实验任务:企业质控标准(测序深度阈值、每样本细胞数下限等)用于数据质控训练;模型微调与轨迹推断对应细胞状态建模与药效动态分析;扰动预测与零样本评测对应候选药物虚拟筛选。
实验报告按企业项目报告体例撰写,须包含方法依据、结果评估与局限性讨论,并附数据来源说明。
评分标准参照产业岗位对数据处理规范性、结果判断能力与报告质量的要求设定,学生由此体验产业真实工作范式。
实验按生物医药企业药物研发流程中的生物信息分析岗位任务设计,操作规范参照企业通行的生物信息分析规范。
| 实验步骤 | 对应产业环节 | 产业规范在实验中的体现 |
|---|---|---|
| 步骤 5—10 | 数据获取与质控 | 学生登记数据来源与使用许可、执行质控阈值判定,模拟企业测序数据交付验收标准 |
| 步骤 11—16 | 细胞状态建模 | 参考图谱比对、注释结果复核与模型迭代,对应企业图谱分析岗位通行流程 |
| 步骤 17—20 | 候选药物虚拟筛选 | 靶点选择须有依据、预测结果须设未扰动细胞对照评测,模拟企业干湿结合筛选模式中的计算先行环节 |
| 步骤 21—22 | 项目交付与汇报 | 报告按企业项目报告体例撰写,须包含方法依据、结果评估、局限性讨论与数据来源说明 |
产业场景的价值在于“没有唯一正确答案”——不同参数与条件下结果不同,考查的是论证过程与证据使用。
| 关键变量 | 条件 | 预期结果与原因 |
|---|---|---|
| 质控参数 (步骤 6—8) | 阈值设在教学参考区间(基因数 200—300、线粒体占比 ≤10%) | 保留大部分有效细胞且低质量细胞被剔除,注释与预测结果稳定;该区间匹配教学数据集的测序深度分布 |
| 过严(如基因数 500)或过松(线粒体占比放宽至 15% 以上) | 过严时稀有细胞类型可能丢失;过松时死亡或受损细胞混入并干扰注释 | |
| 批次校正与分组 (步骤 10) | 先核对分组再校正 | 同类细胞跨批次聚合、批次效应消除 |
| 未核对分组即校正 | 真实生物学差异被削弱,图谱映射后同类细胞分布离散 | |
| 低置信度复核 (步骤 13) | 逐一复核 / 直接采信 | 复核可提高罕见细胞类型识别可靠性;直接采信易将罕见类型误归入主流类型,致细胞构成统计偏差 |
| 微调轮数 (步骤 14—15) | 轮数适中(默认 5 轮) | 验证集指标上升后趋稳,注释与预测表现改善 |
| 轮数过多 / 不足 | 过多触发过拟合预警、指标回落;不足则指标提升有限 | |
| 靶基因依据 (步骤 17—18) | 有文献或调控关系依据 / 无依据扩大筛选 | 有依据时预测变化与已知调控关系一致、可解释性强;无依据时难以与文献对照、说服力弱 |
| 对照与评测情境 (步骤 19) | 设置未扰动细胞对照并作按扰动基因留一的零样本测试 | 获得可与简单基线比较的相关性指标;r ≥0.8 / 0.5—0.8 / <0.5 仅为本教学数据集参考分级,须结合基线、样本量与其他指标解读 |
| 遗漏对照 / 面对训练中未见的扰动基因 | 遗漏对照则差异变化量失去统一参照;基因留一结果仅反映对新型扰动的泛化,不能解释为跨细胞类型或组织情境的泛化能力 |